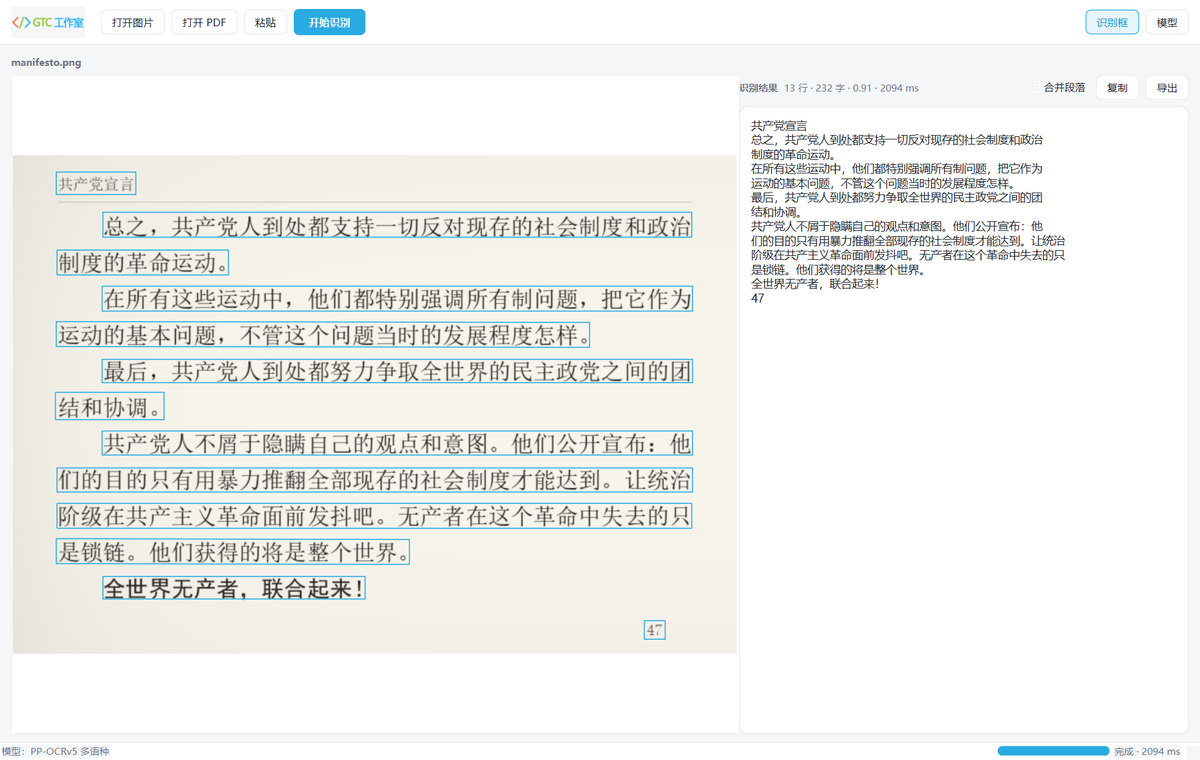
下面这一页《共产党宣言》的结尾是真实样例:图是排好的书页,框和文字都是 GTC 桌面 OCR 跑出来的结果,不是手打的。
真实软件里的进度是分阶段报的:定位文字 → 判断方向 → 识别文字,中途可以取消。
只做一件事:把图里的字变成你能直接用的文本。
图片和 PDF 直接从资源管理器拖进窗口,松手就载入;截图用 Ctrl+V 粘贴即可。
拖拽 / 粘贴 / 打开上一页 / 下一页按钮加页码输入框,翻到哪页看哪页,也能只识别其中几页。
翻页 / 选页多页识别时右侧文字边跑边长,完成一页就出现一页,不用干等到最后。
实时识别模型不焊死在程序里。首次运行点一下下载约 16 MB,之后完全离线。
按需下载图片上扫过一道扫描线,框逐个浮现,进度条按阶段报数,随时能取消。
扫描动画复制进剪贴板,或导出 txt / Markdown / JSON。JSON 里每行带坐标和置信度。
复制 / 导出除了下载模型那一次联网,识别全程在本地 CPU 上跑,不上传、不统计、不登录。
完全离线PP-OCRv4 中英默认,PP-OCRv5 多语种精度更高。在模型管理里点一下就切。
v4 / v5第一次打开会停在引导页,点「下载」拉取约 16 MB 的识别模型。这一步做完,后面都不用再联网。
拖图片进窗口、按 Ctrl + O 选文件、Ctrl + V 粘贴截图,或打开一份 PDF。
按 Ctrl + R 或点「开始识别」。跑完直接 复制,或导出成文件。
都不随程序分发,用哪个下哪个;下载时会校验 SHA-256,坏了会自动丢弃重下。
| 模型包 | 体积 | 语言 | 什么时候选它 |
|---|---|---|---|
| PP-OCRv4 中英 | 16.2 MB | 中文 + 英文 | 默认。日常截图、文档、票据够用。 |
| PP-OCRv5 多语种 | 22.0 MB | 中文 + 英文 + 更多语种 | 实测精度更高,英文词间空格保留更完整。 |
页面演示用的就是 v5:一张 900 × 620 的书页,识别出 13 行 232 字、平均置信度 0.91,本机 CPU 耗时 2~3 秒。速度会随图片尺寸变化。
免安装,解压后双击即可运行。
下载后解压整个文件夹,双击 GTC-OCR\GTC-OCR.exe 即可运行。
第一次运行点「下载模型」(约 16 MB),之后断网也能正常识别。
程序没有代码签名,SmartScreen 可能拦一次。点「更多信息」→「仍要运行」即可,之后不再弹。
模型不打包在程序里,首次要点一下下载(约 16 MB)。之后即使断网也能正常识别。
发布包已带 msvcp140 / vcruntime140。若仍提示缺少运行库,装一次「Microsoft Visual C++ 2015-2022 Redistributable (x64)」。
小字号、模糊、倾斜、低对比度的图会掉准确率。遇到漏字,换 v5 模型或把图放大再识别。